当地时间11月17日,在美国芝加哥举行的SC26国际超级计算大会上,最新一期全球超算TOP500榜单正式揭晓:国家超级计算深圳中心“灵晟”E级超级计算机,以2.198 EFlops的持续双精度浮点性能再次位列全球第一。
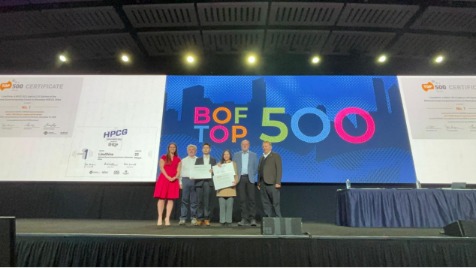
本期榜单共有5台E级超算上榜,“灵晟”的Linpack双精度实测性能较第二名美国劳伦斯利弗莫尔国家实验室的“El Capitan”高出约21%;在侧重访存与互联通信能力的HPCG基准测试中,“灵晟”以22 PFlops同样位居第一,领先第二名约26%;在面向混合精度智能计算的HPL-MxP、超大规模图计算Graph500榜单中,“灵晟”也稳居第一梯队。
作为当前性能最强的E级系统,“灵晟”采用在线加速的全CPU超智融合架构的系统。图灵奖获得者、美国田纳西大学教授杰克·唐加拉评价道:“灵晟是一套令人印象极为深刻的系统,能够解决当今科学计算和人工智能领域最具挑战性的难题,让世界看到了超算通向AI4Science新型系统架构的希望之光。”
从ISC2026到SC2026,“灵晟”的每一次亮相都引发国际超算界和全球科技媒体的高度关注。国际同行普遍认为,以在线加速架构为代表的“中国路线”,正在为后GPU时代的全球算力体系结构提供全新选择。在加速器路线长期主导行业的背景下,这套纯CPUE级超算体现了通往E级算力的技术路径不止一条。
优异的性能,根植于“灵晟”全栈自主的技术底座。“灵晟”打通从芯片、高速互连、存储到系统工程与软件栈的全链路,攻克系列核心技术壁垒,实现从架构定义、代码开发到芯片研制、整机集成的全栈国产化,自主可控。
系统秉持“应用驱动、平衡设计、全栈协同”的设计原则。芯片层,自研LX2 CPU,首创在线加速(Online Acceleration)的全CPU超智融合新架构,原生融合多精度科学计算与矩阵加速能力,实现HPC与AI算力在单芯片内深度协同;搭载首颗国产HBM,内存带宽相较传统CPU提升10倍;网络层,自主研发灵启高速互连网络,具备支撑200万端口、10万节点的超大规模扩展能力;存储层,采用高性能与大容量分级存储架构,支持E级容量平滑扩展;系统软件层,构建面向混合负载的超智融合底座,深度适配并优化HPC+AI软件栈,配套自研全栈软件、Star-Lance加速套件与优化MPI通信库,破解传统CPU+GPU架构的访存与通信瓶颈,为科研应用提供可编程、可深度调优的算力平台;散热与能效层面,灵晟首创100%全液冷方案,兼顾高性能、高效率、高能效三重优势,能效比达52 GFlops/W。
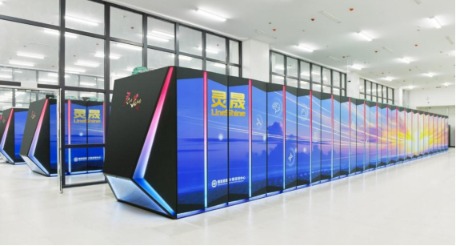
“灵晟”E级超级计算机
“HPC+AI for Science,通过数值模拟和人工智能深度融合的方法共同实现科学研究,正在成为科学发现的重要新范式。”国家超级计算深圳中心主任、“灵晟”总设计师卢宇彤说,“中国高性能计算既要紧跟世界前沿,更要在关键方向形成自己的技术体系、创新范式和引领能力,让世界一流的算力真正产出世界一流的科学与工程成果。”
“灵晟”上线数月,已累计注册用户1600余个,服务高校、科研院所和企业,应用覆盖大气海洋、地球科学、材料科学、生物医药、脑科学、遥感、能源、工业仿真、人工智能等多个重要领域。
在地球科学与城市治理方面,支撑中国气象局下一代数值预报模式MCV,完成1小时内全球5公里10天的数值预报;助力深圳完成百米级城市天气预报精细化模拟,依托万级成员集合同化系统,将公里尺度30天预报任务的全流程计算时间压缩至约2小时。
在材料与新能源领域,依托自主研发的XLSDFT首次完成2亿硅原子体系第一性原理计算,并完成约1133万个原子的锂金属与固态电解质复杂界面模拟;在催化与量子化学领域,依托“灵晟”仅用1.75小时完成固氮酶关键活性中心FeMoco的高精度电子结构求解,上述两项成果均入围2026年ACM戈登贝尔奖。
在生物医药领域,“灵晟”可在22.6小时完成10万亿级可合成化合物空间的分层筛选;在人工智能领域,“灵晟”已部署DeepSeek、Qwen、GLM等主流大模型,形成纯CPU大模型服务能力。AI for Science创新应用能力加快形成,数值模拟与人工智能深度融合的科研新范式,正在这里从愿景变为现实。
回望发展之路,从“天河”到“灵晟”,体系结构自主创新始终是中国超算迭代跃升的核心主线。时隔九年重返巅峰,到本次成功卫冕,标志着中国超算完成从“阶段性登顶”到“持续性领跑”的质变;以“灵晟”重大工程为牵引,我国高端计算产业链加速打通芯片、软件、整机全环节,带动产业链整体能力升级。
锚定“十五五”发展目标,国家超级计算深圳中心将持续夯实自主可控的算力底座,繁荣超智融合应用生态,以一流算力支撑一流科研与产业创新,为加快建设科技强国、数字中国提供坚实支撑。
